AI trong xử lý nước thải hữu ích thật — nhưng ở những việc khiêm tốn hơn nhiều so với cách nó thường được quảng cáo. Nó giỏi phát hiện xu hướng mà mắt người bỏ sót trong hàng nghìn điểm dữ liệu. Nó không thay được người vận hành có kinh nghiệm khi trạm gặp tình huống chưa từng xảy ra.
Bài này nói thẳng về cả hai phía, vì đánh giá sai khả năng của AI là cách nhanh nhất để đầu tư sai.
AI làm tốt việc gì
| Việc | Vì sao AI làm tốt |
|---|---|
| Phát hiện bất thường | So hàng nghìn điểm dữ liệu với dải bình thường, không mệt, không bỏ sót ca đêm |
| Nhận ra xu hướng sớm | Thấy SVI nhích lên đều trong 5 ngày trước khi con số vượt ngưỡng |
| Phát hiện cảm biến sai | Nhận ra số liệu đứng yên, trôi dần, hoặc lệch khỏi quan hệ với cảm biến khác |
| Dự báo ngắn hạn | Ước lượng lưu lượng, tải vài giờ tới dựa trên chu kỳ sản xuất đã lặp lại |
| Gợi ý điều chỉnh có biên | Đề xuất mức sục khí, liều hóa chất trong dải an toàn đã xác định |
Điểm chung: những việc có quy luật lặp lại và có đủ dữ liệu lịch sử.
AI chưa làm được việc gì
Xử lý tình huống chưa từng có trong dữ liệu. Một nguồn xả độc tố mới, một loại nước thải chưa gặp bao giờ — mô hình không có cơ sở để dự đoán.
Thay phán đoán của người có kinh nghiệm. Người vận hành lâu năm biết bùn "trông không ổn" từ màu và mùi trước khi số liệu thay đổi. Mô hình chỉ biết những gì được đo.
Bù cho dữ liệu kém. Cảm biến bẩn, thiếu số liệu, ghi sai đơn vị — mô hình học từ dữ liệu sai sẽ dự báo sai một cách tự tin.
Tự quyết định thao tác không đảo ngược được. Xả bùn lớn, chuyển dòng sang hồ sự cố, châm clo xử lý bùn — cần người xác nhận.
Dữ liệu là điều kiện tiên quyết
Trước khi nghĩ tới AI, bốn câu hỏi về dữ liệu:
- Có đủ dài không? Cần dữ liệu bao gồm các chu kỳ thật — ngày, tuần, mùa, và lý tưởng là có cả giai đoạn sự cố
- Có đủ dày không? Ghi mỗi ngày một lần thì không thấy được dao động trong ngày
- Có đúng không? Cảm biến được hiệu chuẩn, có đối chiếu với phòng thí nghiệm
- Có liên kết không? Số liệu cảm biến, phòng thí nghiệm, sản xuất, can thiệp vận hành nằm cùng một trục thời gian
Phần lớn trạm chưa đạt câu 2 và câu 4. Đó là lý do bước đầu tiên của hầu hết dự án AI thực tế là sửa dữ liệu, không phải xây mô hình.
Vì sao mô hình tốt khi thử nghiệm lại sai khi vận hành
Đây là hiện tượng rất phổ biến, với các nguyên nhân thường gặp:
Dữ liệu huấn luyện không đại diện. Mô hình học từ ba tháng trạm chạy ổn định, rồi gặp mùa mưa hoặc nhà máy đổi sản phẩm.
Điều kiện thay đổi theo thời gian. Thiết bị già đi, đĩa phân phối khí tắc dần, hệ vi sinh thích nghi — quan hệ giữa các biến thay đổi, mô hình cũ không còn đúng.
Đánh giá sai cách. Kiểm tra mô hình trên dữ liệu trộn lẫn với dữ liệu huấn luyện cho kết quả đẹp giả tạo. Phải kiểm tra trên giai đoạn mô hình chưa từng thấy.
Cảm biến hỏng sau khi triển khai. Mô hình nhận dữ liệu sai và đưa ra kết luận sai.
Hệ quả: mô hình cần được theo dõi và cập nhật liên tục, không phải xây một lần rồi để đó.
Mức độ tự động hóa nên có
| Mức | AI làm gì | Người làm gì |
|---|---|---|
| Cảnh báo | Phát hiện bất thường, báo động | Đánh giá và quyết định |
| Gợi ý | Đề xuất điều chỉnh kèm lý do | Duyệt hoặc từ chối |
| Tự điều chỉnh có biên | Tự chỉnh trong dải an toàn đã đặt | Đặt biên, giám sát |
| Tự quyết hoàn toàn | — | Không khuyến nghị cho xử lý nước thải |
Hầu hết trạm nên bắt đầu ở mức cảnh báo và gợi ý. Chỉ tiến lên tự điều chỉnh khi đã có thời gian dài kiểm chứng mô hình trên chính trạm đó, và luôn giữ biên an toàn do người đặt.
Đo hiệu quả thế nào cho đúng
Đừng tin con số tiết kiệm hay độ chính xác được công bố trước khi có số liệu thật của trạm bạn. Hiệu quả của AI phụ thuộc rất nhiều vào chất lượng dữ liệu và đặc điểm từng trạm.
Cách đánh giá đáng tin:
- Lập đường cơ sở trước khi triển khai
- Đo trên chỉ số cụ thể: số sự cố phát hiện sớm, thời gian phản ứng, kWh/m³, định mức hóa chất
- So sánh cùng điều kiện tải
- Theo dõi cả lợi ích lẫn cảnh báo sai
Tất cả bài trong chuyên đề
Danh sách đầy đủ các bài hướng dẫn chi tiết của chuyên đề này được cập nhật liên tục tại chuyên mục AI và phân tích dữ liệu.
X-IRIS tiếp cận AI theo thứ tự đúng
Chúng tôi không bắt đầu từ mô hình. Chúng tôi bắt đầu từ dữ liệu:
- Thu dữ liệu sạch và liên tục từ cảm biến, PLC, phòng thí nghiệm, gắn cùng trục thời gian
- Phát hiện cảm biến sai trước khi dữ liệu sai đi vào phân tích
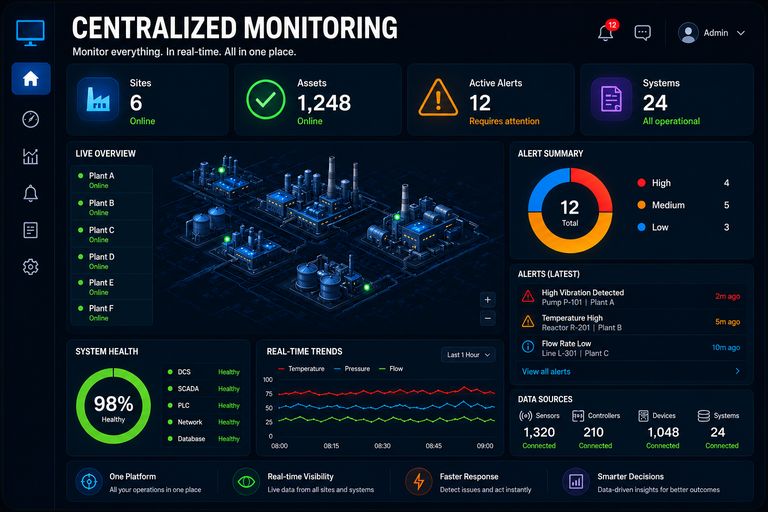
- Cảnh báo theo xu hướng — phát hiện SVI, DO, pH đi lệch dần trước khi vượt ngưỡng
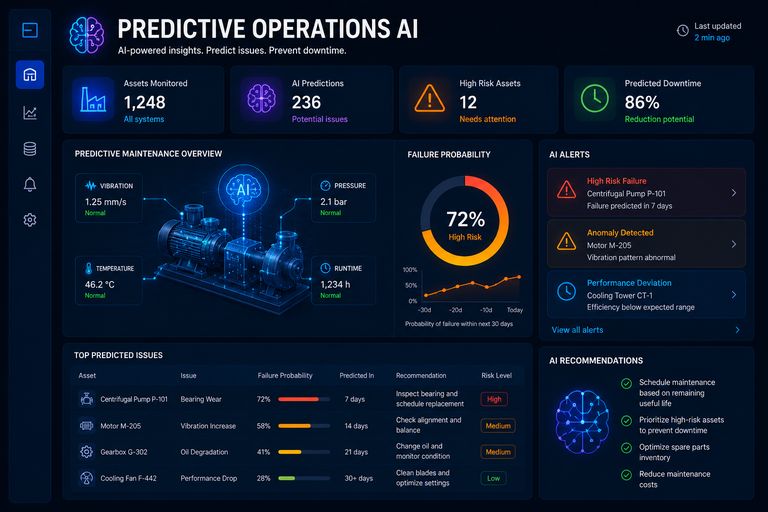
- Dự báo rủi ro tuân thủ khi có đủ dữ liệu lịch sử, kèm mức độ tin cậy
- Gợi ý có giải thích — người vận hành thấy vì sao hệ thống đề xuất, và luôn có quyền quyết định cuối
Mức độ tự động hóa được mở rộng dần, theo kết quả kiểm chứng trên chính trạm của Quý vị — không theo hứa hẹn chung.
Bước tiếp theo
Gửi phiếu khảo sát hiện trạng trạm của Quý vị →
Phiếu giúp đánh giá dữ liệu trạm đang có, cảm biến nào sẵn sàng và bước nào hợp lý trước. Đội kỹ thuật X-IRIS đọc rồi trao đổi lại.
Liên hệ: 0919 124 338 · erp.xiris@gmail.com
Xem thêm: Dự báo rủi ro bằng AI · Giám sát vận hành tập trung
Câu hỏi thường gặp
Trạm nhỏ có dùng được AI không? Được, nếu có dữ liệu đủ dày và đủ dài. Quy mô trạm không quyết định — chất lượng và độ liên tục của dữ liệu mới quyết định.
Cần bao nhiêu dữ liệu để bắt đầu? Không có con số cố định. Tối thiểu cần dữ liệu bao trùm các chu kỳ vận hành thật của trạm. Cảnh báo bất thường có thể bắt đầu sớm hơn nhiều so với dự báo.
AI có thay được người vận hành không? Không. AI giúp người vận hành thấy sớm hơn và quyết định tốt hơn, nhưng phán đoán trong tình huống mới và trách nhiệm quyết định vẫn thuộc về người.
Làm sao biết dự báo của AI đáng tin? Hỏi mô hình được kiểm chứng trên dữ liệu nào, giai đoạn nào, sai số bao nhiêu, và khi nào nó không chắc chắn. Một hệ thống tốt phải cho biết mức độ tin cậy của từng dự báo, không chỉ đưa ra một con số.